Een sitemap vermeldt de URL’s van een website, zodat zoekmachines ze makkelijker kunnen ontdekken. Maar dat er pagina’s in staan, betekent niet dat Google ze allemaal crawlt of indexeert. Een sitemap indienen blijft een aanwijzing voor zoekmachines, geen garantie. Om optimaal gebruik te maken van dit bestand, moet je begrijpen wat erin staat, wat ontbreekt en hoe je het met andere gegevens kunt vergelijken om te achterhalen welke pagina’s daadwerkelijk toegankelijk zijn.
XML-sitemap en HTML-sitemap: twee bestanden, twee toepassingen
Heb je weleens een webpagina gezien die eruitziet als een enorme inhoudsopgave, met tientallen links die per categorie zijn ingedeeld? Dat is een HTML-sitemap. Die is bedoeld voor menselijke bezoekers en helpt hen navigeren wanneer een menu niet volstaat.
Een XML-sitemap is daarentegen een technisch bestand. Het is niet bedoeld om door bezoekers te worden gelezen, maar richt zich rechtstreeks tot crawlers zoals Googlebot. Elke URL wordt vergezeld van informatie, zoals de datum waarop de pagina voor het laatst is gewijzigd (het veld lastmod).
Een concreet voorbeeld: op een reissite staan de pagina’s van de sitemap van 1001 Découvertes in een gestructureerd bestand dat zoekmachines kunnen crawlen. Zo’n bestand helpt de crawler recente of bijgewerkte pagina’s te vinden zonder de hele site link voor link te hoeven doorzoeken.
Een technisch punt om te onthouden: Google negeert de velden priority en changefreq in een XML-sitemap. Het invullen ervan verandert de crawlfrequentie niet. Alleen lastmod kan de crawler naar een recent bijgewerkte pagina leiden, mits het veld een daadwerkelijke wijziging van de inhoud weerspiegelt.
Sitemap, interne links en het indexeringsrapport met elkaar vergelijken
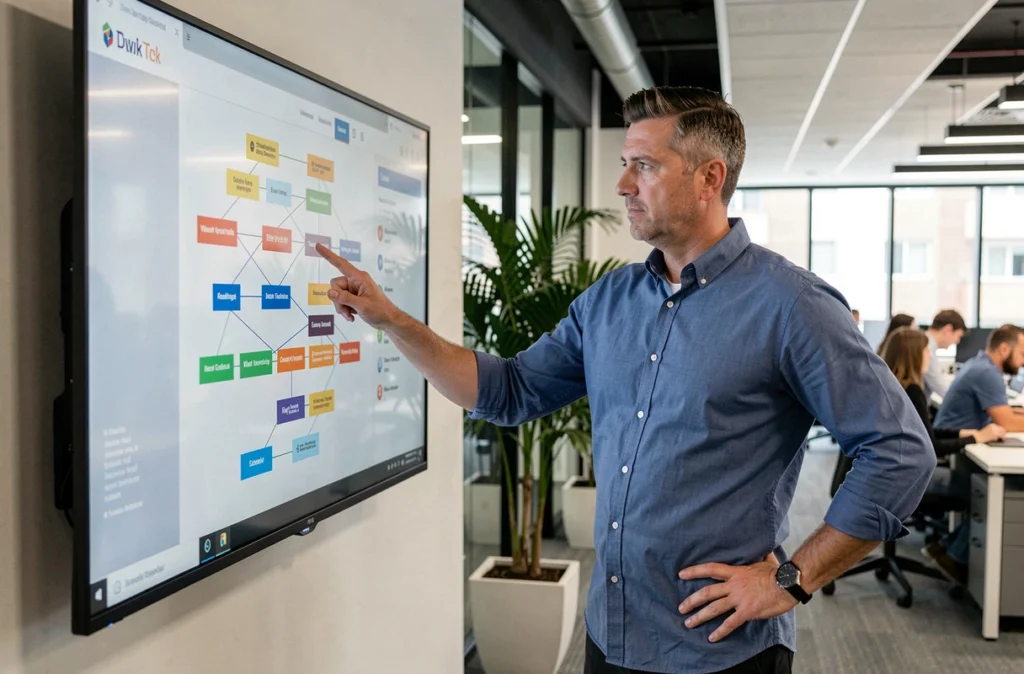
De meeste handleidingen stoppen bij het aanmaken van het bestand. Het echte werk begint daarna, wanneer je drie gegevensbronnen met elkaar vergelijkt: de sitemap, de interne linkstructuur van de site en het indexeringsrapport van Google Search Console.
Waarom deze vergelijking alles verandert
Een URL kan in je sitemap staan zonder dat er interne links naartoe leiden. Google ontdekt de URL, maar beschouwt de pagina niet als prioritair omdat geen enkele andere pagina ernaar verwijst. Het gaat dan om een gemelde, maar slecht geïntegreerde weespagina.
Omgekeerd kan een pagina via het hoofdmenu bereikbaar zijn, maar ontbreken in de sitemap. De crawler vindt de pagina alsnog, maar je mist het versheidssignaal dat lastmod kan afgeven.
Het indexeringsrapport van Search Console voegt daar een derde laag aan toe. Het maakt onderscheid tussen ontdekte pagina’s (Google kent de URL), gecrawlde pagina’s (de crawler heeft de inhoud gelezen) en geïndexeerde pagina’s (ze verschijnen in de zoekresultaten). Deze drie statussen vallen niet altijd samen.
Zo spoor je verschillen op
Met een crawltool zoals Screaming Frog kun je alle URL’s uit de XML-sitemap ophalen en vergelijken met de URL’s die daadwerkelijk via de interne navigatie bereikbaar zijn. Deze vergelijking brengt het volgende aan het licht:
- URL’s in de sitemap die een 404-fout of een 301-omleiding opleveren: ze vervuilen het bestand en verspillen het crawlbudget van de crawler.
- Strategische pagina’s die ontbreken in de sitemap, terwijl ze verkeer genereren: door ze toe te voegen, versterk je het signaal aan Google.
- URL’s in de sitemap met een noindex-instructie: een tegenstrijdigheid die zoekmachines een verwarrend signaal geeft.
- Weespagina’s zonder interne links die alleen in de sitemap voorkomen: de kans is klein dat ze blijvend worden geïndexeerd.
Een betrouwbare sitemap bevat alleen toegankelijke pagina’s zonder fouten of tegenstrijdige instructies. Het oplossen van zulke inconsistenties heeft vaak meer impact dan het toevoegen van nieuwe URL’s.
Technische beperkingen van sitemaps en de indeling voor grote websites
Het sitemapprotocol stelt strikte eisen. Elk XML-bestand is beperkt tot 50 000 URL’s of 50 MB ongecomprimeerd. Daarboven moet je de URL’s over meerdere bestanden verdelen en die bundelen in een sitemapindex.
Voor een e-commercesite met duizenden productpagina’s is die indeling geen detail. Eén overvol bestand vertraagt de analyse door de crawler. Door URL’s per categorie te verdelen (producten, blogartikelen, merkpagina’s) wordt het bovendien makkelijker om problemen op te sporen wanneer een groep pagina’s niet meer wordt geïndexeerd.
Wanneer een HTML-sitemap de XML-sitemap aanvult
Voor een kleinere site is een HTML-sitemap een nuttige aanvulling. Die bevat interne links naar dieper gelegen pagina’s die niet prominent in het hoofdmenu staan. Gebruikers die de weg kwijt zijn in de sitestructuur kunnen de sitemap als snelkoppeling gebruiken.
Op een grotere site wordt een HTML-sitemap al snel onoverzichtelijk. Je kunt je inspanningen beter richten op de XML-sitemap en een doordachte interne linkstructuur, met contextuele links in de redactionele inhoud.
Je sitemap controleren en actueel houden
Een sitemap die je één keer aanmaakt en daarna nooit bijwerkt, verliest zijn waarde. Telkens wanneer een pagina wordt verwijderd, omgeleid of op noindex wordt gezet, moet het bestand worden bijgewerkt zodat het de werkelijke staat van de site weerspiegelt.
CMS’en zoals WordPress genereren vaak automatisch een sitemap. Dat is handig, maar er zit een addertje onder het gras: het automatisch gegenereerde bestand bevat soms onnodige pagina’s (tagarchieven, paginering, concepten die per ongeluk zijn gepubliceerd). Door de inhoud regelmatig te controleren, voorkom je dat je Google onnodige signalen stuurt.
Na elke update van de sitemap kun je deze via Google Search Console indienen om een snellere crawl aan te vragen. Het dekkingsrapport toont vervolgens hoeveel pagina’s zijn ingediend, gecrawld en geïndexeerd. Die drie cijfers vertellen hoe de zoekmachine je site daadwerkelijk ziet.
Een sitemap blijft een communicatiemiddel tussen je site en crawlers. De waarde ervan hangt volledig af van de mate waarin het bestand overeenkomt met de werkelijke sitestructuur: interne links, HTTP-statussen van pagina’s en indexeringsinstructies. Met een schoon, actueel bestand dat aansluit op de interne navigatie geef je zoekmachines de beste voorwaarden om je inhoud te crawlen en te indexeren.